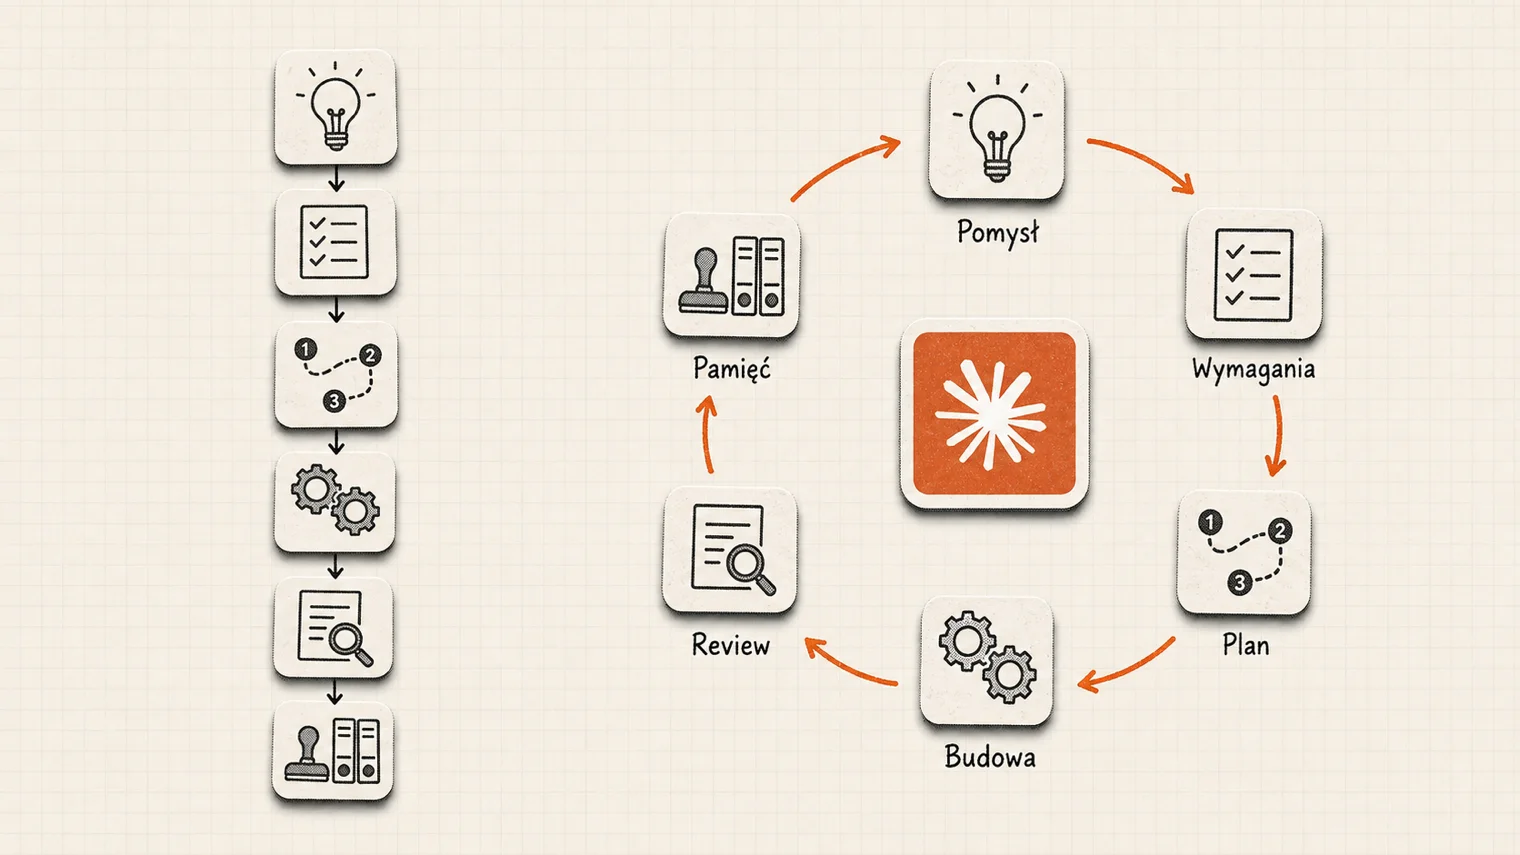
Vibe coding to budowanie aplikacji przez opisywanie jej AI zwykłym językiem: piszesz, co chcesz zbudować, a sztuczna inteligencja zajmuje się resztą. I co najważniejsze, nie musisz znać się na programowaniu. Tyle że vibe coding bez planu starcza do pewnego momentu. Jeżeli chcesz zbudować aplikację, która ma działać dla prawdziwych użytkowników, trzeba robić to inaczej: najpierw spisana specyfikacja (co ma powstać i jak), potem testy, dopiero potem kod. To połączenie dwóch podejść: spec-driven development i test-driven development. Nie jestem programistą, a w ten sposób buduję zarówno aplikacje mobilne, jak i webowe. W tym wpisie pokazuję cały proces krok po kroku na jednym przykładzie, razem z narzędziami, które go pilnują.
Kilka dni temu Anthropic opublikował playbook o tym, jak wygląda cykl tworzenia oprogramowania z agentami AI w ich zespołach. Czytałem go z dziwnym uczuciem, bo sześć etapów, które tam opisali, to prawie jeden do jednego proces, który sam sobie wypracowałem przez ostatnie miesiące. Metodą prób, błędów i przepalonych tokenów. Różnica jest taka, że oni piszą do klienta Enterprise z dużym zapleczem technicznym, a ja do Ciebie: osoby, która chce sama zbudować swój produkt albo narzędzie i nie ma za sobą studiów informatycznych.
Najpierw spisujesz, co dokładnie ma powstać, w jakich ramach i w jakiej kolejności, a AI buduje krok po kroku według tego dokumentu i nie wychodzi poza niego. Zamiast prompta z głowy masz specyfikację, którą czytasz i zatwierdzasz przed pierwszą linijką kodu.
Dobra praktyka ze świata IT: zanim powstanie kod, powstają testy, które sprawdzają, czy aplikacja robi to, co miała. Kod jest gotowy dopiero wtedy, gdy przechodzi wszystkie testy, więc nie musisz wierzyć AI na słowo.
01. Co to jest vibe coding i dlaczego nie wystarcza?
Vibe coding to podejście do programowania, w którym opisujesz aplikację językiem naturalnym, AI generuje kod, a Ty oceniasz efekt i prosisz o poprawki, nie zaglądając do kodu.
Vibe coding to termin, który Andrej Karpathy rzucił w lutym 2025 roku i który błyskawicznie stał się synonimem kodowania z AI. Opisujesz, co chcesz, agent koduje, czyli duży model językowy generuje kod (w Claude Code, Cursorze czy Codexie, wszystko jedno), Ty patrzysz na efekt, mówisz „nie, inaczej" i AI nanosi poprawki. Da się tak zbudować sporo rzeczy, do których dotychczas potrzebny był zespół IT i miesiące programowania: landing page, aplikację webową lub mobilną, nawet grę. To też coś innego niż no-code: tam klikasz gotowe klocki, tu powstaje prawdziwy kod, tylko go nie czytasz.
Problem z vibe codingiem bez zbudowanego środowiska zaczyna się, kiedy projekt urośnie. Aplikacja ma dwadzieścia ekranów, logowanie, bazę danych, a Ty prosisz o poprawkę w formularzu i Claude Code przy okazji zmienia coś innego. Nagle aplikacja przestaje działać. Wszystko przez to, że brakuje mu środowiska, które trzyma go za rękę: mówi, co dokładnie ma zrobić, i co najważniejsze, w jaki sposób, żeby osiągnąć określony cel.
Spec-driven development odwraca kolejność. Najpierw rozmowa, która kończy się dokumentem wymagań. Potem plan, który zatwierdzasz. Potem testy, które opisują, jak funkcja ma się zachowywać. Dopiero wtedy AI zaczyna pisać kod, a Ty w rozmowie z nim konsultujesz najważniejsze decyzje i mówisz, jak Ty to widzisz.
Czy takie podejście zajmuje więcej czasu? Na starcie tak, o godzinę albo dwie. Na końcu projektu jest dużo szybsze, bo nie poprawiasz co chwilę błędów AI, które działało bez planu.
02. Skąd wziął się mój proces (i dlaczego wygląda jak playbook Anthropic)
Mój proces powstał z błędów, na które wpadałem przy vibe codingu. W codziennej pracy opieram się na procesach, bo proces jest powtarzalny i przewidywalny, a tego brakowało mi w pracy z AI. Każdy z sześciu kroków dokładałem wtedy, gdy poprzednia wersja zawiodła w konkretny sposób.
Na co dzień pracuję w Claude Code i na nim pokazuję cały proces. Same kroki nie są jednak przywiązane do jednego narzędzia: dokument wymagań, plan, przegląd i pamięć projektu da się odtworzyć w Cursorze czy innym środowisku agentowym. Zmienią się komendy, nie zasada.
Zaczynałem pracę z tymi narzędziami jak każdy. Pisałem, co ma powstać, czekałem na wynik, a potem więcej czasu spędzałem na poprawkach niż na samym budowaniu. I tak za każdym razem.
Pierwszy klocek systemu wziął się właśnie stąd: zanim pozwoliłem Claude Code cokolwiek zbudować, kazałem mu spisać wszystko w jasny, konkretny plan, na którym ma się wzorować. Pomogło, ale kod i tak miał błędy. Wtedy pojawili się recenzenci: po każdym wykonanym etapie uruchamiani są subagenci, którzy skanują zmiany pod różnymi kątami, wyszukują błędy, a te potem są poprawiane. Trzecią warstwą był test-driven development: każda funkcja dostaje testy, zanim powstanie jej kod, więc błąd wychodzi od razu, a nie u użytkownika.
Czwarty element to pamięć projektowa. Przy dużym projekcie Claude Code popełnia błędy, a najgorsze są te, które popełnia drugi raz. Dlatego dostał bazę wiedzy, w której zapisuje swoje wtopy i sposób, w jaki je naprawił, żeby przy kolejnym zadaniu ich nie powtarzać.
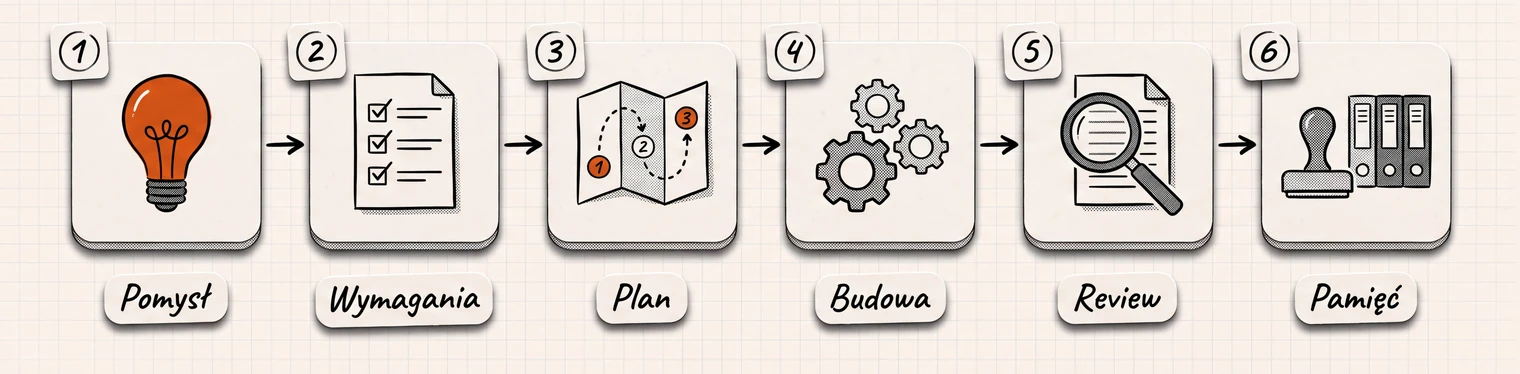
Kiedy przeczytałem playbook Anthropic, okazało się, że oni doszli do tego samego układu: plan, projekt, budowa, testy, wdrożenie, utrzymanie. Z jednym dokumentem na granicy każdego etapu i człowiekiem, który go zatwierdza. Różnica jest w odbiorcy. Oni piszą do firm z branży technologicznej, z działem IT, architektami i zespołem bezpieczeństwa. Moje podejście jest dla osób nietechnicznych, które chcą same budować swoje produkty albo narzędzia.
03. Przykład, na którym to pokażę
Sześć kroków procesu i siódmy, który domyka zadanie, przejdziemy na projekcie, nad którym teraz pracuję: generatorze ofert online dla handlowca. Narzędzie tworzy ofertę na podstawie transkrypcji rozmowy handlowca z klientem. Klient, zamiast standardowego PDF-a na maila, dostaje unikalny link, pod którym mieści się jego oferta.
Handlowiec ma pełną analitykę. Widzi, ile czasu klient spędził na stronie, które sekcje przeglądał, a nawet heatmapę, gdzie jeździł kursorem.
Klient może zaakceptować ofertę jednym kliknięciem, a handlowiec od razu dostaje o tym powiadomienie.
Na tym projekcie pokażę Ci, jak wygląda start: pierwsza faza wdrożenia, czyli fundament. Szkielet aplikacji, baza danych z izolacją kont, serwer na dwóch domenach i pierwszy powtarzalny deploy. Zero ekranów, sama infrastruktura, czyli faza, którą jako nietechniczny najchętniej bym pominął, a bez niej każda kolejna wali się przy pierwszym prawdziwym użytkowniku. Dziś projekt jest na fazie siódmej i każda przeszła przez ten sam proces, więc od razu zobaczysz, jak możesz wykorzystać to na starcie własnej aplikacji.
04. Krok 1: Zamieniasz pomysł w dokument wymagań
Zaczynasz od rozmowy, nie od kodu. Skill /dev-brainstorm przepytuje Cię pytanie po pytaniu, aż będzie jasne, co dokładnie ma powstać, i zapisuje odpowiedzi jako dokument wymagań w projekcie.
/dev-brainstorm [opis Twojego pomysłu]Każdy nowy projekt zaczynam od tego skilla. Pomaga mi ułożyć pomysł z głowy w gotowy plan: zadaje serię pytań, a z odpowiedzi powstaje dokument, na podstawie którego Claude Code będzie budował projekt.
Przy każdym z sześciu kroków pokazuję to samo: co do niego wchodzi (input) i co z niego wychodzi (output). Dzięki temu widzisz, że każdy krok kończy się konkretnym plikiem w projekcie, nie „mniej więcej gotowym" efektem.
Twój pomysł: co ma robić narzędzie, po co je budujesz i dla kogo.
Dokument z wymaganiami i koncepcją w docs/brainstorms/, punkt wyjścia dla wszystkich dalszych kroków.
Przy generatorze ofert dostałem serię pytań, często o rzeczy, których w ogóle nie wziąłem pod uwagę. Skill zadaje jedno pytanie naraz. Czy sterowanie narzędziem przez Claude Code budujemy w całości na końcu, czy najpierw prostą wersję? Ile kont użytkowników potrzebujemy w trakcie budowy? Analityka czytania oferty ma być przed przyciskami akcji dla klienta, czy po nich? Brzmi banalnie, dopóki nie zorientujesz się, że na połowę tych pytań nie masz odpowiedzi. To często pytania o skrajne przypadki, o których osoba nietechniczna po prostu nie ma pojęcia.
Bez tego skilla szybko dochodziłbym do ściany: budowałbym w złej kolejności albo wybrał podejście, które wrzuciłoby mnie na minę, a potem tygodniami wszystko odkręcał.
Mam jeszcze jeden skill, którym poddaję plan drugiej próbie: /zroastuj-mnie. Plan, który wymyślił Claude Code, wrzucam mu z powrotem w roli krytyka, który szuka dziur w całym. Prawie zawsze wychodzą rzeczy, których brainstorm nie złapał, i łatam je, zanim ruszy budowa. Oba skille to sporo czasu zwykłej rozmowy z Claude Code, ale wychodzę z założenia, że podwójne sprawdzenie planu zawsze się opłaca.
Najważniejsze po tym etapie: masz gotowy plan, który jest punktem wyjścia dla wszystkich dalszych kroków. I pamiętaj, że ten dokument to nie jeden przebieg szablonu, który opisuję dalej. Przy generatorze ofert brainstorm podzielił projekt na dziesięć faz wdrożenia, od fundamentu po gotowość produkcyjną, każda z warunkiem zaliczenia. Kolejny projekt może mieć osiem faz albo więcej. Nie dlatego, że Claude Code nie potrafi więcej naraz, tylko dlatego, że jedna faza musi mieścić się w ramach, które da się zbudować, sprawdzić i domknąć. Część roboty idzie w małych, połączonych ze sobą krokach, część w kilku większych.
05. Krok 2: Spisujesz, co musisz dostarczyć sam
Zanim Claude Code zacznie planować, skill /dev-prep tworzy listę rzeczy, których żaden subagent za Ciebie nie zrobi: decyzje, konta w zewnętrznych usługach, klucze dostępu, grafiki i makiety ekranów.
W poprzednim kroku powstał dokument, który podzielił aplikację na 10 faz. Zanim ruszy pierwsza z nich i Claude Code zacznie pisać kod, zostaje kilka rzeczy do zrobienia. Bo to narzędzie, mimo wszystkich możliwości, nie zrobi wszystkiego samo. Część rzeczy musi wykonać człowiek, czyli operator. Od tego jest skill /dev-prep.
Używam go tak: podaję ścieżkę do dokumentu z kroku 1 i zaznaczam, którą fazę zaczynamy. W konsoli Claude Code wygląda to tak:
/dev-prep @docs/brainstorms/2026-08-24-fazy-wdrozenia-mvp-requirements.md Faza 1Skill zwraca listę tego, co muszę przygotować, zanim puszczę Claude Code do pisania kodu.
Dokument wymagań z kroku 1.
Checklista dla człowieka w docs/operator/. Przy fundamencie było na niej 11 pozycji, m.in.: odzyskać dostęp do projektu bazy danych w Supabase, założyć dwa projekty w Sentry i skopiować klucze, utworzyć aplikację na serwerze z dwiema domenami, wpisać zmienne środowiskowe, zdecydować, jak robimy środowisko testowe.
Najczęściej są to klucze dostępu, konta w zewnętrznych usługach, sekrety w pliku .env, a także grafiki i makiety ekranów, które chcę zobaczyć, zanim trafią do aplikacji. Ten krok jest moim własnym dodatkiem. Wymyśliłem go, bo jako nietechniczny najczęściej blokowałem się nie na kodzie, tylko na rzeczach obok kodu. Autopilot potrafił dojechać do czwartej fazy i stanąć, bo brakowało jednego klucza. Teraz każda taka pozycja ma marker [blokuje: faza N] i pipeline nie ruszy dalej, dopóki jej nie odhaczysz.
Przy ekranach dochodzi Figma, program do projektowania interfejsów, w którym rysuje się wygląd ekranów, zanim ktoś je zaprogramuje. Zanim pozwolę Claude Code coś zbudować, chcę wiedzieć, jak to będzie wyglądało, bo wygląd aplikacji jest mega ważny, a poprawianie go po fakcie kosztuje najwięcej. Claude Code podłącza się do Figmy przez MCP i przygotowuje makiety, czyli wstępne wizualizacje ekranów. Podrzucam mu strony, które mi się podobają, albo szukam inspiracji przez MCP Mobbin, bazę tysięcy ekranów aplikacji webowych i mobilnych. Na tej podstawie robi mi na przykład 5 wersji jednego widoku, wybieram tę, która podoba mi się najbardziej, i wszystko zostaje w Figmie. Tak iteruję wygląd aplikacji, zanim powstanie jakikolwiek kod.
Z wybranych widoków powstaje plik design.md, w którym trzymam standardy wyglądu: kolory, czcionki, rozmiary, obramowania, cienie. Dzięki temu aplikacja jest spójna i każdy ekran wygląda tak samo, a nie każdy trochę inaczej. Builder buduje potem ekran pod makietę, a tester porównuje efekt z projektem. Jak to działa technicznie, opisałem we wpisie o Figma MCP w Claude Code.
Checklista przejrzana od początku do końca odblokowuje budowę. Ale zanim Claude Code zacznie pisać kod, potrzebuje jeszcze szczegółowego planu: co zbudować, gdzie i jak. O tym w kroku 3.
06. Krok 3: Plan powstaje sam, Ty go zatwierdzasz
Skill /dev-plan skanuje projekt subagentami i dzieli robotę na etapy z konkretnymi jednostkami do zbudowania. Potem /dev-docs zamienia plan w zadanie dla autopilota. Kod nie powstaje bez zatwierdzonego planu.
Po tym, jak przygotujesz wszystko jako operator, powstają dwa dokumenty. Pierwszy tworzy skill /dev-plan. Podajesz mu ten sam dokument wymagań i fazę, którą zaczynasz:
/dev-plan @docs/brainstorms/2026-08-24-fazy-wdrozenia-mvp-requirements.md Faza 1Skill najpierw wysyła subagentów typu research, którzy skanują kod bieżącego projektu i sprawdzają, co już jest, a co trzeba dobudować. Potem dzieli robotę na etapy z konkretnymi jednostkami do zbudowania. Innymi słowy: to plan wykonawczy, co powstanie i w jakiej kolejności. Zapisuje się w folderze docs/plans/.
Dokument wymagań + checklista z kroku 2.
Plan techniczny w docs/plans/. Dla fundamentu: pięć etapów (szkielet repozytorium, baza danych i izolacja kont, serwer, szkielet panelu, kontener i pierwszy deploy) i osiem jednostek do zbudowania, każda z celem, plikami, przydzielonym builderem i scenariuszami testów.
Każda jednostka w planie ma cel, pliki, podejście i scenariusze testowe. To ostatnie jest ważne: testy są opisane, zanim powstanie kod, więc builder w kroku 4 najpierw pisze test, a potem kod, który ten test przechodzi. Stąd w tym procesie jest test-driven development.
Gdy plan jest gotowy, uruchamiasz drugi skill, /dev-docs, tym razem ze ścieżką do planu, już bez fazy:
/dev-docs @docs/plans/2026-08-24-001-feat-faza-1-fundament-plan.mdZatwierdzony plan z docs/plans/ i checklista operatora z kroku 2.
Zadanie dla autopilota: folder docs/active/faza-1-fundament/ z kontekstem, planem etapów i listą zadań, plus nowa gałąź w Gicie. Co jest w środku, niżej.
Po co dwa dokumenty? Plan z /dev-plan odpowiada na pytanie „co i jak zbudować" i jest napisany dla człowieka, który go zatwierdza. /dev-docs zamienia ten plan w zadanie dla autopilota: tnie go na etapy, dokłada kontekst, który mają dostać buildery i recenzenci, i robi listę zadań z checkboxami, po której autopilot odhacza postęp. Pierwszy dokument to decyzja, drugi to instrukcja wykonania. Sprawdza też bramkę gotowości: czy wszystkie pozycje z checklisty operatora, które blokują tę fazę, są odhaczone.
Powiem szczerze: to długie dokumenty i nie czytam ich od początku do końca. Są pisane dla agenta AI, nie dla człowieka. Sprawdzam, czy etapy mają sens biznesowy (czy izolacja danych jest zbudowana i przetestowana, zanim cokolwiek trafi na serwer), i puszczam dalej. Czy zbudowano dokładnie to, co w planie, sprawdza recenzent zgodności ze specyfikacją w kroku 5.
Każda jednostka w planie ma też wskazane, jakie skille mają być użyte. Oprócz komend, które pokazuję w tym artykule, w szablonie jest grono innych skilli, dopasowanych do konkretnych czynności w kodzie: praca z bazą danych, bezpieczeństwo, monitoring błędów. Z Twojej perspektywy to nie ma znaczenia. Komendy, które tu pokazuję, same decydują, co powinno zostać użyte.
Po tym kroku w projekcie jest nowy folder docs/active/faza-1-fundament/ z trzema plikami:
- docs/
- active/
- faza-1-fundament/
- faza-1-fundament-plan.md
Mapa zadania: lista etapów z numerami i tym, co każdy ma dowieźć.
- faza-1-fundament-kontekst.md
To, co buildery i recenzenci dostają do ręki przed pracą: zasady projektu, decyzje z brainstormu, blokery operatora.
- faza-1-fundament-zadania.md
Lista zadań z checkboxami, po której autopilot odhacza postęp i z której wznawia się po przerwie.
- faza-1-fundament-plan.md
- faza-1-fundament/
- active/
I jeszcze jedna rzecz, najważniejsza: Claude Code tworzy nową gałąź w Gicie, feature/faza-1-fundament. Cała budowa dzieje się na niej, a nie na głównej wersji projektu. Jeśli autopilot coś zepsuje, główna wersja jest nietknięta.
Program, który zapisuje historię zmian w kodzie. Każdy zapis (commit) mówi, co się zmieniło, kiedy i dlaczego, więc zawsze możesz wrócić do wersji, która działała.
Osobna kopia projektu, na której pracujesz bez ruszania wersji głównej. Gdy zmiany są sprawdzone, łączysz gałąź z główną. Gdy nie wyszły, kasujesz ją i główna wersja tego nie widzi.
07. Krok 4: Odpalasz autopilot i wracasz za kilka godzin
Autopilot to workflow, który wykonuje wszystkie etapy planu po kolei: dla każdego etapu pisze testy i kod, robi przegląd, naprawia znalezione błędy i dopiero wtedy przechodzi do następnego. Jedno zadanie potrafi trwać kilka, a przy większych funkcjach kilkanaście godzin.
Co to oznacza dla Ciebie? Tyle, że uruchamiasz jedną komendę i wracasz za kilka albo kilkanaście godzin na skończoną robotę:
/dev-autopilot-wf @docs/active/faza-1-fundamentTo najprostszy i najprzyjemniejszy krok. Wszystko, czego Claude Code potrzebuje, już jest w folderze docs/active/: kontekst, plan etapów i lista zadań. Ty wracasz do raportu, nie do kodu.
Zadanie z kroku 3 (folder docs/active/ z kontekstem, planem etapów i listą zadań).
Pięć etapów fundamentu zbudowanych na osobnej gałęzi, 72 testy na zielono, raport przeglądu po każdym etapie i plik stanu, z którego autopilot potrafi się wznowić po przerwie.
Jak to działa? Za autopilotem stoi mechanizm, który w Claude Code nazywa się Dynamic Workflows. To zapisany scenariusz, który uruchamia poszczególne skille po kolei według listy zadań i którego Claude Code nie może zmienić w trakcie. Kolejność etapów, bramki jakości i limity napraw są w scenariuszu. Claude Code wykonuje zadania, ale nie decyduje, czy może pominąć przegląd. To największa różnica między moim podejściem a zwykłym „zrób mi to": sterowanie trzyma scenariusz, nie model.
Mechanizm w Claude Code, który pozwala zapisać w pliku scenariusz wielu kroków (jakie skille odpalić, w jakiej kolejności, co zrobić, gdy coś pójdzie nie tak) i wykonać go jako całość, bez pilnowania rozmowy krok po kroku. Włącza się go w ustawieniach Claude Code, bez niego autopilot nie ruszy.
Autopilot bierze pierwszy etap z planu (plan dzieli fundament na etapy, coś jak rozdziały) i wykonuje go do końca. Jeśli w pierwszym etapie ma do stworzenia pięć plików, pisze je po kolei, każdy z testami. Potem uruchamia przegląd: sprawdza, czy wszystko zostało zbudowane tak, jak stoi w planie (rozwinę to w kroku 5). Jeśli przegląd znajdzie błędy, autopilot je naprawia. Dopiero wtedy etap jest gotowy i autopilot przechodzi do następnego.
Kto pisze kod? Trzech przygotowanych, wyspecjalizowanych subagentów:
- jeden od ekranów, czyli tego, co widzisz,
- drugi od bazy danych i uprawnień,
- trzeci od logiki, która odpowiada za to, jak aplikacja działa, czyli tego, czego nie widzisz.
Przy fundamencie prawie wszystko robi ten drugi: baza, izolacja kont, serwer, kontener. Szkielet panelu, jedyna jednostka z interfejsem, idzie do tego od ekranów. Każdy ma wgrane skille pod swój obszar i każdy sam koduje i testuje swój fragment, zanim zgłosi etap jako gotowy. To jest to, co w dokumentacji nazywa się claude code agents i claude code skills. Agent to osobna rozmowa z własną rolą i własną pamięcią, skill to instrukcja, którą agent doczytuje, gdy jej potrzebuje.
Wszyscy subagenci przez cały czas mają dostęp do reguł spisanych w pliku .claude/rules/coding-rules.md. Są tam dwa rodzaje zasad. Pierwsze to zwykłe zasady dobrego programowania, takie same jak w zespole ludzi. Drugie to lista zachowań AI, których zabraniam, bo sam się na nie nadziałem: osłabianie testów, żeby przeszły, ciche obniżanie progów jakości, dopisywanie funkcji, o które nikt nie prosił. Jeśli kiedykolwiek widziałeś, jak agent „naprawia" test tak, żeby przechodził niezależnie od wyniku, wiesz, po co ta lista. Reguły przychodzą z szablonem, ale plik żyje: w kroku 6 projekt dopisuje do niego własne wnioski i Twój agent uczy się, jak ten konkretny projekt jest zbudowany.
Dwie rzeczy, na które musisz się nastawić: czas i tokeny. Każdy etap jest pisany, testowany i sprawdzany kilka razy, a nie raz, więc autopilot robi więcej kroków niż zwykłe „zrób mi to". W zamian masz dużo większą pewność, że to, co powstało, działa. Fundament Ofert Online zajął łącznie około 6 godzin pracy autopilota i przepalił około 8 milionów tokenów. Dlatego uruchamiam go wieczorem albo przed wyjściem z domu, a rano robię smoke, przegląd i merge, o czym w kroku 7. Jak zadbać o limity w Claude Code i nie przepalać ich za szybko, opisałem we wpisie o limitach w Claude Code.
08. Krok 5: Siedmiu recenzentów i sceptycy sprawdzają robotę
Po każdym etapie do siedmiu niezależnych subagentów przegląda kod równolegle: bezpieczeństwo, wydajność, jakość, poprawność, zgodność ze specyfikacją, pokrycie testami i testy w prawdziwej aplikacji. Każde poważne znalezisko przechodzi jeszcze przez sceptyka, który próbuje je obalić.
W autopilocie kluczowym momentem jest walidacja tego, co zostało stworzone. Po każdym etapie siedmiu niezależnych subagentów przegląda kod równolegle, każdy pod innym kątem.
Każde poważne znalezisko przechodzi jeszcze przez sceptyka, który próbuje je obalić. Chodzi o to, że recenzenci AI czasem dają sprzeczne sygnały: jeden mówi, że coś nie działa, choć działa. Sceptyk jest po to, żeby odrzucić fałszywe alarmy, bo każda naprawa kosztuje tokeny i czas.
Zmiany z etapu + plan + lista zadań.
Raport z podziałem na błędy blokujące, zastrzeżenia i drobiazgi, plus decyzja: etap przechodzi albo wraca do naprawy.
Tak wyglądało to przy fundamencie. Recenzent zgodności ze specyfikacją wychwycił, że baza pozwala właścicielowi nadpisać treść już opublikowanej oferty, a naczelna zasada projektu mówi, że opublikowanej oferty nie da się zmienić. Recenzent testów zauważył, że jest test na to, że widzę własne dane, ale nie ma testu na to, że nie widzę cudzych. Recenzent poprawności znalazł, że serwer przechodzi wszystkie testy, ale nie startuje jako proces, bo testy wołały aplikację z pominięciem warstwy sieciowej. Tester przeglądarkowy w fundamencie się nie odpalił, bo nie było czego przeklikać.
Skład recenzentów zależy od tego, czego etap dotyka. Etap z samą bazą danych nie płaci za recenzenta ekranów. Tester odpala się tylko wtedy, gdy w liście zadań jest scenariusz do przeklikania.
Sceptycy to część, z której jestem najbardziej zadowolony. Każde znalezisko blokujące dostaje trzech niezależnych weryfikatorów, którzy muszą się zgodzić w dwóch na trzech. W trzecim etapie fundamentu recenzenci zgłosili 54 uwagi. Po usunięciu duplikatów zostało 27, do sceptyków poszło 11 poważnych, 5 z nich odpadło jako fałszywe alarmy. Bez sceptyków naprawiałbym rzeczy, które nie były zepsute. Drobiazgi mają twardy limit na raport, bo inaczej raport ma 60 pozycji i nikt go nie czyta.
09. Krok 6: Projekt zapamiętuje, na czym się wyłożył
Każdy rozwiązany problem trafia do docs/solutions/, powtarzalne wnioski stają się regułami dla wszystkich subagentów, a pojęcia z Twojej domeny lądują w słowniku docs/CONCEPTS.md. Im dłużej pracujesz w projekcie, tym mniej błędów Claude Code powtarza.
Ostatni etap autopilota, gdy zakończy budowę, sprawdzanie i weryfikację swojej pracy, to aktualizacja pamięci projektu. Podczas budowy Claude Code trafia na różnego rodzaju przeszkody i problemy, i to jest moment, w którym je spisuje, zanim ulecą z kontekstu.
Robią to dwa skille. /dev-compound dokumentuje każdy rozwiązany problem jako osobny plik w docs/solutions/: co się stało, jak to wykryto, jak naprawiono i po czym to poznać następnym razem. Jeśli w tej sesji pojawiło się pojęcie z Twojej domeny, dopisuje też hasło do słownika docs/CONCEPTS.md. Powtarzalne wnioski trafiają do reguł, które czyta każdy subagent. Potem /dev-compound-refresh przegląda całą bazę i archiwizuje to, co się zdezaktualizowało, żeby stare rozwiązania nie wprowadzały w błąd.
Kontekst sesji, zmiany w kodzie, raporty przeglądu z kroku 5.
Plik z rozwiązaniem (np. dlaczego serwer cofał poprawny deploy, choć aplikacja działała, i trzy ciche pułapki, które za tym stały), wpis w regułach, hasło w słowniku.
Następna faza, która dotyka deployu, zacznie od gotowego rozwiązania, nie od zera. Przed budową subagent learnings-researcher przeszukuje bazę i podrzuca builderowi tylko to, co pasuje do bieżącego zadania.
Słownik służy do tego, żeby Claude Code w kolejnych sesjach wiedział, jakie wyrażenia, skróty i pojęcia występują w projekcie, i nie musiał Cię dopytywać ani zgadywać. Brzmi jak przesada, dopóki Claude Code nie „naprawi" Ci czegoś, co celowo działało nietypowo. W Ofertach Online „liczba osób, które czytały ofertę" to szacunek, nie fakt, bo nie odróżniamy powrotu tej samej osoby od dwóch różnych osób. Bez hasła w słowniku model prędzej czy później zamieni to na twardą liczbę i pokaże ją w panelu jako pewnik. Jedno hasło w słowniku załatwia sprawę na zawsze.
10. Krok 7: Sprawdzasz ręcznie i oddajesz kod do zewnętrznej recenzji
Po autopilocie i aktualizacji pamięci zostaje jeszcze jeden dokument do przejścia krok po kroku, tak samo jak checklista przed startem. Do tego opcjonalna, ale polecana druga weryfikacja: recenzja kodu przez narzędzie z zewnątrz.
Pierwsza rzecz to smoke operatora i tego kroku nie pomijasz. Gdy autopilot kończy zadanie, tworzy w docs/operator/ listę testów najważniejszych funkcji, które przeklikujesz ręcznie, żeby mieć pewność, że wszystko jest zgodne z tym, co chciałeś zbudować. Na liście jest wyłącznie to, czego automat nie mógł sprawdzić sam. Przy fundamencie były to: czy aplikacja naprawdę wstaje na obu domenach, czy deploy na serwerze przechodzi bez cofnięcia, czy błędy dolatują do monitoringu. Przechodzisz listę punkt po punkcie z Claude Code, on prowadzi, Ty klikasz, a przy wybranych funkcjach Claude Code robi jeszcze własną weryfikację wtórną, zanim uzna projekt za ukończony.
Zbudowana faza na gałęzi + lista smoke z docs/operator/.
Przeklikana lista smoke, pull request włączony do głównej wersji projektu, nowe wpisy w bazie wiedzy z uwag CodeRabbita.
Testy były zielone, a mimo to smoke złapał problem, którego autopilot nie miał prawa wykryć: baza główna dostała starszą wersję schematu niż testowa. Dlatego ten dokument to nie formalność.
Druga rzecz, już dodatkowa, to zewnętrzna weryfikacja, czyli code review. W dużych firmach programistycznych to standard: zanim zmiana trafi do głównej wersji projektu, ogląda ją ktoś, kto jej nie pisał, i szuka błędów, których autor nie widzi, bo za długo patrzył na własny kod. Ja nie mam zespołu, więc tę rolę pełni CodeRabbit, bot do recenzji kodu na GitHubie. Działa tak: gdy wysyłasz pull request, żeby włączyć gałąź do głównej wersji, CodeRabbit sprawdza wszystkie naniesione zmiany i odpisuje, co wymaga poprawy.
Konfigurację robi za Ciebie skill /coderabbit-setup: wykrywa, na czym stoi projekt, i tworzy plik ustawień dopasowany do Twojego stacku. A /dev-pr obsługuje resztę od początku do końca. Tworzy pull request, czeka na recenzję bota, klasyfikuje jego uwagi według wpływu na projekt, prowadzi tury poprawek i, co dla mnie najważniejsze, zapisuje do bazy wiedzy klasy błędów, które bot znalazł po naszym własnym przeglądzie. Bo jeśli CodeRabbit widzi coś, czego siedmiu moich recenzentów nie widziało, to znaczy, że któremuś brakuje reguły. Przy fundamencie CodeRabbit zrobił cztery przebiegi, a w trzecim i czwartym większość uwag dotyczyła kodu dodanego przy naprawianiu poprzedniej rundy. Poprawki po review trzeba sprawdzać tak samo jak pierwszy kod.
Przegląd kodu przez kogoś, kto go nie pisał, zanim zmiana trafi do głównej wersji projektu. Wyłapuje błędy, które autor przestał widzieć.
Prośba o włączenie zmian z gałęzi do głównej wersji projektu, z podglądem wszystkiego, co się zmieniło. To miejsce, w którym odbywa się code review.
11. Jakie narzędzia do vibe codingu, poza Claude Code
Sam Claude Code to za mało. Wokół niego jest sześć narzędzi, z których każde pilnuje innego etapu.
- Figma to makiety ekranów. Najpierw poprawiam wygląd na makiecie, potem builder buduje pod nią, a tester porównuje efekt z projektem.
- Mobbin to baza tysięcy ekranów prawdziwych aplikacji webowych i mobilnych. Stąd biorę inspiracje, zanim poproszę Claude Code o warianty widoku.
- GitHub trzyma kod i historię decyzji. Każde zadanie to osobna gałąź i pull request, więc zawsze wiesz, kiedy i dlaczego coś się zmieniło.
- CodeRabbit to zewnętrzny recenzent AI na GitHubie. Sprawdza każdy pull request niezależnie od moich subagentów, a jego znaleziska zasilają bazę wiedzy.
- Supabase to baza danych, logowanie i uprawnienia, wspólne dla wersji webowej i mobilnej.
- Sentry zbiera informacje o błędach, które występują w aplikacji, gdy już jest udostępniona użytkownikom. Zamiast czekać, aż ktoś napisze „coś nie działa", masz zgłoszenie z dokładnym miejscem w kodzie, a skill
/bugfixstartuje od niego, nie od zgadywania.
Wersja webowa stoi na React i Vite, mobilna na Expo z publikacją przez EAS. Skille techniczne są inne, pipeline ten sam.
12. Co daje vibe coding z planem i ile kosztuje
Daje przewidywalność i oprogramowanie, które przetrwa więcej niż demo. Kosztuje czas na starcie i tokeny, bo każda linijka jest pisana, testowana i sprawdzana kilkukrotnie.
- Nie oceniam kodu, bo nie umiem. Oceniam wymagania, checklistę i raport przeglądu, a to umiem, bo są po polsku i o produkcie. Efekt widzę w gotowej aplikacji: przeglądam ją i testuję ręcznie.
- Każde zadanie zostawia ślad: dlaczego coś zbudowano tak, a nie inaczej, jest w plikach, nie w mojej pamięci.
- Ten sam błąd nie wraca drugi raz. System uczy się na własnych błędach, żeby w przyszłości ich nie powtarzać.
- System jest przenośny. Wystarczy skopiować go do nowego projektu i od razu działasz, na webie i na mobile.
Cena to godzina lub dwie na brainstorm, przygotowanie i plan, zanim powstanie pierwsza linijka, oraz kilka do kilkunastu godzin pracy autopilota na plan Max. Przy prototypie na jeden wieczór to za dużo. Przy aplikacji, którą ktoś ma używać przez lata, to najtańsza część projektu.
13. Jak zacząć: szablon w 4 krokach
Cały system jest w dwóch publicznych repozytoriach na GitHubie: claude-code-starter dla aplikacji webowych i workspace-template-mobile dla mobilnych. Nie musisz go rozumieć w całości, żeby zacząć, wystarczy skopiować jeden folder.
- Sklonuj repo:
claude-code-starter(web) alboworkspace-template-mobile(mobile). - Skopiuj folder
.claude/do swojego projektu. - Wpisz
/configw Claude Code i ustaw Dynamic workflows natrue. To włącza autopilot. - Wpisz
/dev-brainstormi opisz, co chcesz zbudować. Resztą pokieruje pipeline.
Jeśli dopiero zaczynasz, możesz iść etapami: najpierw sam /dev-brainstorm i /dev-plan, bo działają bez autopilota, a dopiero potem pełny pipeline. W README każdego repo jest pełna dokumentacja: wszyscy subagenci, każdy workflow i pułapki, na które sami wpadliśmy. Jest tam też Output Style „adhd", jeśli masz dość odpowiedzi zaczynających się od ściany tekstu.
Najczęstsze pytania o vibe coding i spec-driven development
Czy spec-driven development ma sens dla osoby nietechnicznej?
Czym różni się vibe coding od spec-driven development?
Ile trwa jedno zadanie na autopilocie?
Czy muszę używać całego szablonu, czy mogę wziąć część?
Czy vibe coding wystarczy, żeby stworzyć aplikację bez programowania?
Co to są claude code skills i claude code agents?
Co znaczy vibe coding po polsku?
Czym vibe coding różni się od tradycyjnego programowania?
Jakie narzędzia do vibe codingu?
Czy vibe coding zastąpi programistów?
14. Podsumowanie
Sześć kroków procesu, siódmy na domknięcie, jeden folder do skopiowania. Na koniec dwie rzeczy, których nie było wyżej:
- Zacznij od kroku 6, nie od kroku 1. Zanim wdrożysz cały pipeline, załóż w obecnym projekcie folder
docs/solutions/i po każdym rozwiązanym problemie poproś Claude Code o zapisanie go tam z krótkim opisem przyczyny. Za miesiąc zobaczysz, ile razy uratowało Cię to przed powtórką. - Czytaj raporty przeglądu jak klient, nie jak programista. Pytanie nie brzmi „czy ten kod jest dobry", tylko „czy recenzent zgodności ze specyfikacją potwierdził, że powstało to, co zamówiłem". Na to pytanie umiesz odpowiedzieć bez studiów informatycznych.
A jeśli chcesz zobaczyć, jak ten proces wygląda na żywo, od pustego folderu do działającej aplikacji: dokładnie tak prowadzimy kurs Claude Code i kurs aplikacji mobilnych w Akademii.